研究過程
research process
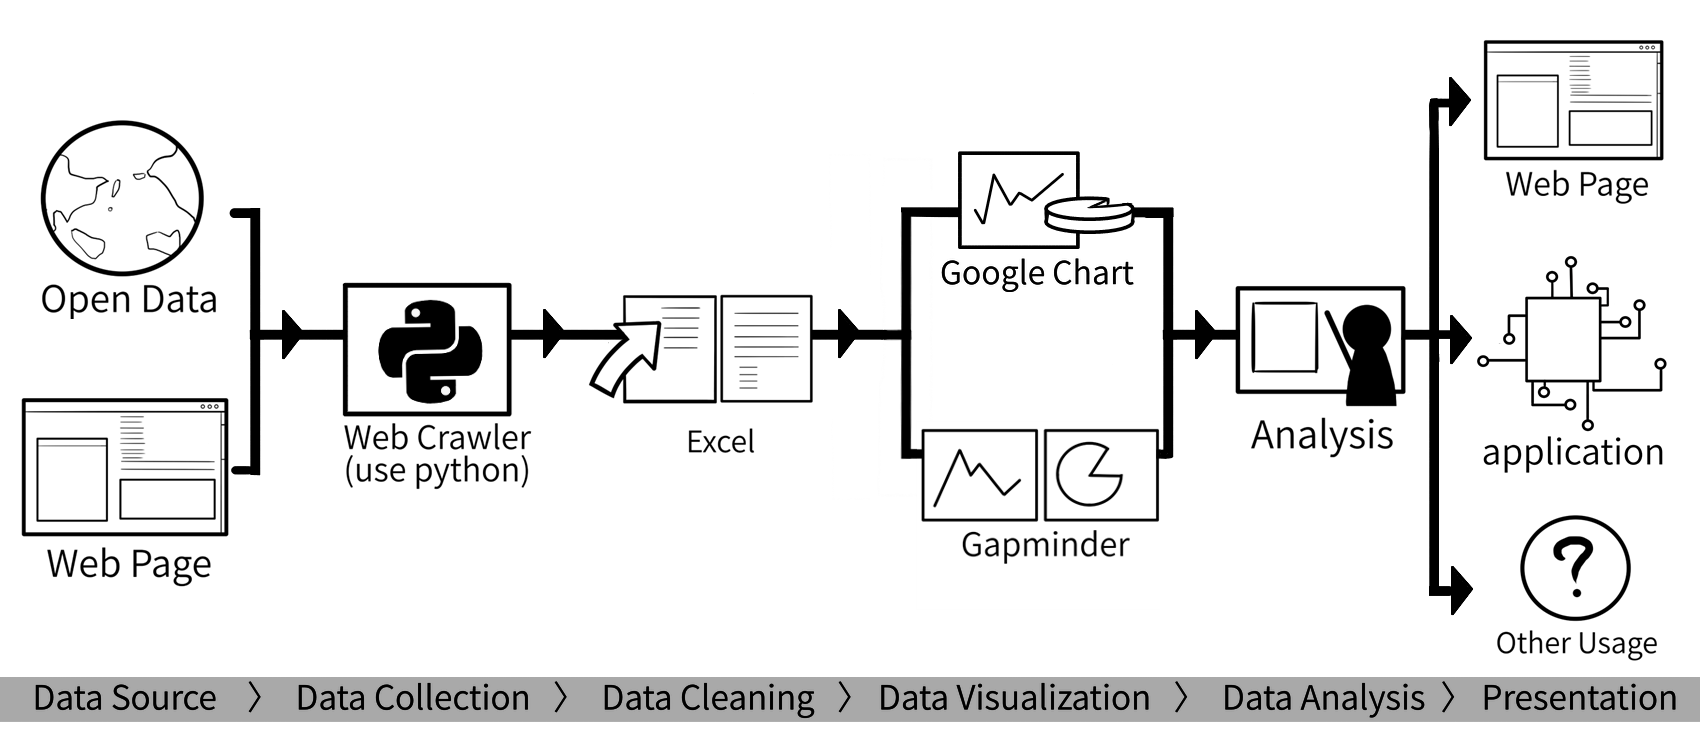
研究過程
一、從政府開放資料平台將所需資料匯入並清理;大量資料如歷年各月各氣象站的降雨量則使用python網路爬蟲程式取得資料。
二、將原始資料特徵化與格式處理後,使用視覺化工具gapminder產生圖表,對資料進行初步分析。
三、依據製作的圖表討論問題,分析影響變化趨勢的原因,並呈現結果。
首先從水利署、中央氣象局等開放資料平台取得需要的原始資料後,檢查過濾、並整理,若遇到較複雜、大量的資料,例如:歷年歷月各氣象站觀測資料,就要寫python網路爬蟲程式來截取,再整理我們需要的格式。 再來使用統計程式gapminder和雲端資訊視覺化平台tableau public做出圖表,來將資料視覺化並分析,使我們更能看出資料的變化趨勢。 發現問題點後,到相關的網站或文獻查詢原因,比對資料中呈現的趨勢與變化的影響因素,之後得出結論。
使用工具-Web Crawler
import urllib
import urllib.request
from bs4 import BeautifulSoup
import csv
csvfile=open("20181103v2.csv","w",newline='')
csvfile_year=open("20181103year.csv","w",newline='')
writer_year=csv.writer(csvfile_year)
writer=csv.writer(csvfile)
writer.writerow(['年份','月份','測站','雨量'])
writer_year.writerow(['年份','測站','雨量'])

for y in range(1998,2019):
    rainfallsum={}
    for m in range(1,13):
        urlstr="https://www.cwb.gov.tw/V7/climate/monthlyData/Data/mD"+str(y)+str(m)+".htm"
        print(urlstr)
        page=urllib.request.urlopen(urlstr).read()
        soup=BeautifulSoup(page,"html.parser")
        stories = soup.find_all('td')
        j=14
        sum_j=0
        print("length=",len(stories))
        for i in stories:
            print(j,stories[j].text,stories[j+4].text)
            writer.writerow([y,m,stories[j].text,stories[j+4].text])
            if m==1 or rainfallsum.get(stories[j].text)==None:
                rainfallsum[stories[j].text]=0
            if stories[j+4].text=='T' or stories[j+4].text=='':
                rainfallsum[stories[j].text]=rainfallsum[stories[j].text]+0
            else:
                rainfallsum[stories[j].text]=rainfallsum[stories[j].text]+round(float(stories[j+4].text),1)
            if m==12:
                writer_year.writerow([y,stories[j].text,rainfallsum[stories[j].text]])
            if j+13 < len(stories):
                j=j+12
                sum_j=sum_j+1
                print("j=",j)
            else:
                break
#           writer_year.writerow([y,stories[j].text,rainfallsum])
        if y==2018 and m==10:
            break
csvfile.close()
csvfile_year.close()
專題報告團隊成員
國立台東女子高級中學